
硬盘其实一直在“自述”:磁头、盘片、电机的每一次异常,都被固件记进SMART计数器。从第一次异常计数到彻底掉线,通常还留着几十天。这几十天有没有人看见,决定了一次更换是计划内的,还是一场事故。
一、谁在盯着这块盘
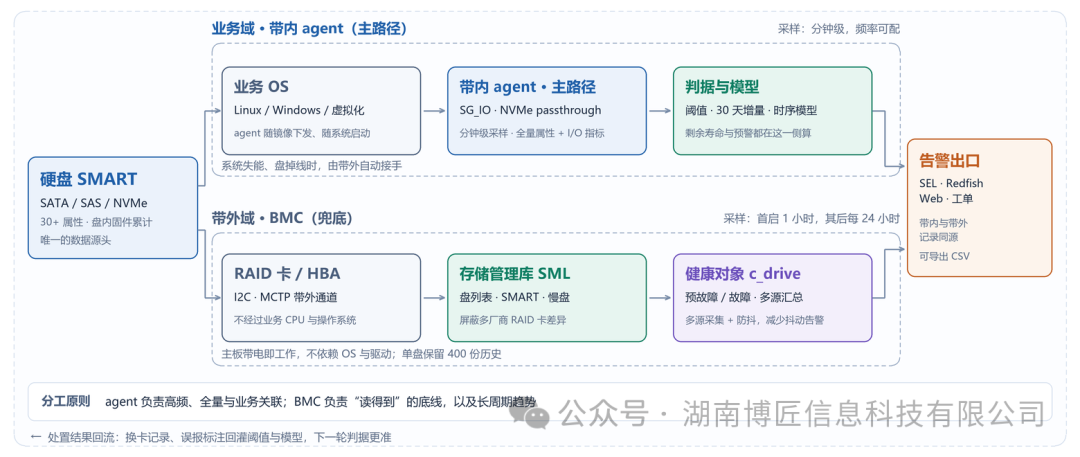
日常的盯盘工作由业务系统里的一个agent完成。它随系统启动,直接向硬盘读数据,采样可以细到分钟级;除了SMART,还能拿到I/O时延、重试次数和文件系统报错。阈值判断、30天增量、预测模型都跑在这一侧——只有它能把“这块盘变慢了”和业务的实际变化对上。
BMC是第二条通道,负责兜底。它在带外对SATA和NVMe盘定时采SMART:开机后一小时一次,此后每24小时一次,单块盘最多保留400份记录,可以直接在Web上翻看,也能通过Redfish导出。存储管理页面把每块盘的预故障信息汇总成一个健康状态,多来源的数据自动合并去重,读得慢的盘会被单独标出来(图1)。
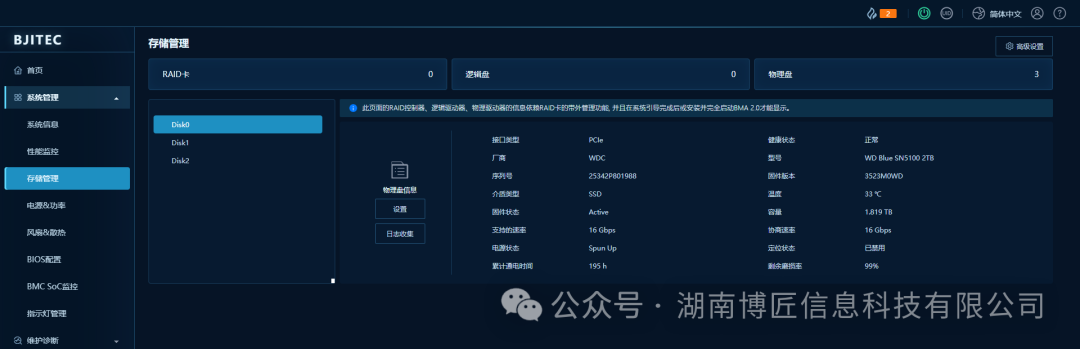
承载这套能力的是HM700智能管理子卡:一颗四核A55、2G内存的独立小系统,自带千兆网口,对外提供Web、IPMI和Redfish接口。硬盘信息经RAID卡或NVMe通道带外读取,不占用业务CPU。
agent有三种场面必然缺席:系统还没起来(批量装机、PXE、系统崩溃)、系统卡死(内核挂住、I/O阻塞)、盘直接从系统里消失。这三种情况BMC都在——它在带外,主板带电就工作。平时agent高频采,异常时BMC接手(图2)。
Backblaze2025年度报告统计了344,196块盘,全年故障率1.36%,比2024年的1.55%略低——这是所有型号、所有机龄平均之后的结果,看着温和。Google早年对10万块盘的研究给出另一面:首年故障率1.7%,用了三年以上超过8.6%,同一批盘第三年的坏盘概率是首年的5倍;而出现过首次扫描错误的盘,其后60天内的故障概率约为正常盘的39倍。
一块盘能上报约30项SMART属性,真正与故障强相关的不超过10项。
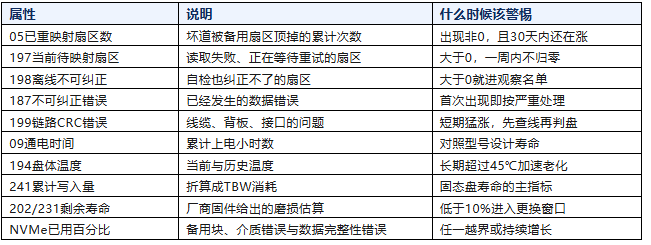
读这些数字有三条经验:看增量不看累计——用满五年的盘有8个重映射扇区很正常,一个月新增8个就不正常;看组合不看单点——重映射、待映射、不可纠正同时抬头,基本可以判断盘片在退化;看趋势不看数值——各厂商对属性的定义并不统一,直接按数值卡阈值经常误判。
最便宜的办法是阈值:厂商给每项属性设了故障前阈值,越界就报警。缺点是阈值往往设在“已经坏”的位置,等它响,盘就该换了。进一步看趋势:重映射30天新增多少、待映射有没有归零、换线之后CRC还涨不涨——单块盘自己就能算,成本几乎为零。
再往上才是模型:把多组时序数据交给机器学习,公开研究的准确率大致在85%~90%。难点不在算法,而在样本——真正坏掉的盘只占百分之一,而且A型号训练出来的模型搬到B型号,往往要打折扣。更麻烦的是,即使把全部SMART属性都用上,仍有约36%的故障盘在此之前没有任何异常计数。
所以判据必须分层:agent侧跑阈值和趋势,高频数据就地判掉;平台侧汇总多台机器的样本,把每次处置的结果变成标签;BMC侧保留同一套阈值和24小时趋势,作为agent缺席时的兜底。
会不会坏是一个问题,还能用多久是另一个。两类盘的失效机理不同,估算路径也不同(图3)。
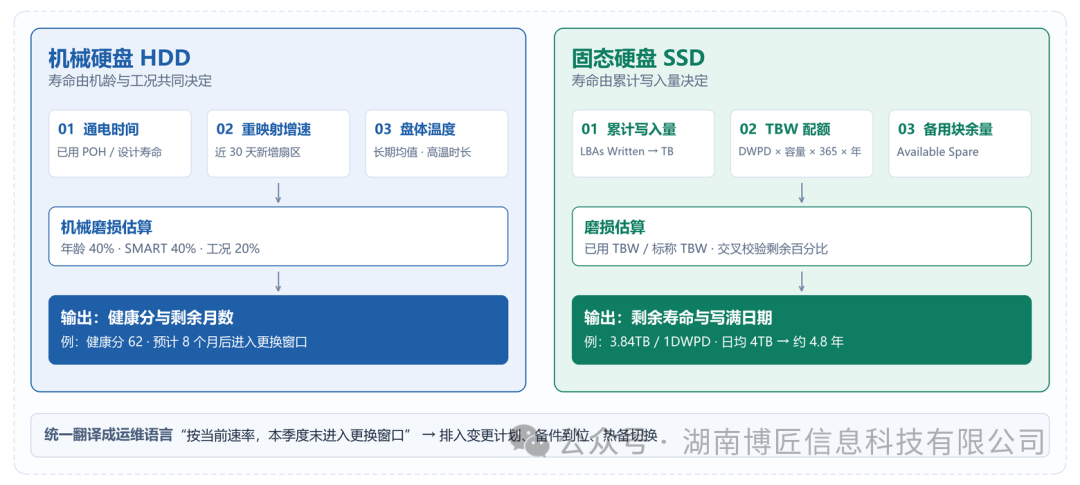
机械盘由机龄和工况共同决定。常见的三个输入是:通电时间占设计寿命的比例、重映射的增长速度、盘体温度的长期均值,按40/40/20加权成一个健康分——分数本身不重要,重要的是它随时间单调下降,运维一眼能看懂。
固态盘看写入量:一块3.84TB、每天写满一次(1DWPD)、保修5年的盘,标称总写入量约7000TB;按日均写入4TB算,大约1750天、也就是4.8年写满。再用盘自己报的剩余寿命和备用块余量交叉校验——写放大会让真实消耗快于理论值。
结果要翻译成运维能用的语言。不是“还剩1750天”,而是“按当前写入速度,本季度末进入更换窗口”——只有后者能排进变更计划、触发备件申请。
门槛可以按业务容忍度调,但告警必须绑定动作:只写进日志、不触发操作的告警,三个月后不会有人再看。
硬盘会坏,但从“开始不对劲”到“彻底掉线”通常还留着几十天。这段时间能不能用上,取决于数据有没有被持续记录:日常靠agent分钟级采样,系统失能或盘掉线时由带外BMC接手。
