
伯乐大模型多模型路由系统构建了包含 6 个模型的基座模型池,并引入两阶段路由架构,在总参数量不足 200B 的前提下,在四个编码基准测试中取得 83.4% 的平均得分。该成绩不仅追平并微幅超越了 TB 级万亿参数级的单体大模型(83.2%),更证明了 200B 参数模型矩阵能够通过高效的路由编排实现 TB 级万亿级模型的综合效能,为高性能 AI Coding 从中心云下沉至企业边端节点与终端工作站。
一、AI Coding 走向边端侧,首先要打破“唯参数规模”
传统方案将所有代码生成请求统一交由云端超大模型处理,导致推理成本与网络延迟居高不下。然而,现实开发中大量基础编码任务(如简单函数补全、局部语法修复等)对模型推理能力的要求存在天花板,持续调用超大模型存在显著的算力冗余与资源浪费。
伯乐大模型多模型路由系统的核心设计理念犹如“伯乐相马”:为每条用户的 Query 动态匹配能力与成本最契合的模型。但在业界实践中,路由器设计始终面临一组核心矛盾:
复杂路由器(打分模型 / 强化学习驱动):拟合能力强,但 OOD(分布外)泛化成本高昂,且极易对训练阶段的模型集合产生过拟合。简单路由器(kNN / 检索式):工程实现轻量、易于横向扩展,但在 Query 级别的细粒度判别上能力不足。针对上述痛点,伯乐大模型多模型路由系统创新性地采用了两阶段递进式路由机制。该机制首先通过低成本的检索方案进行候选模型粗筛,再将置信度较低、难以判定的复杂请求交由 LLM 裁判进行精排仲裁,从而在推理成本、响应延迟与生成质量之间取得了最佳平衡。
二、两阶段路由,让200B参数模型矩阵逼近TB级万亿参数能力
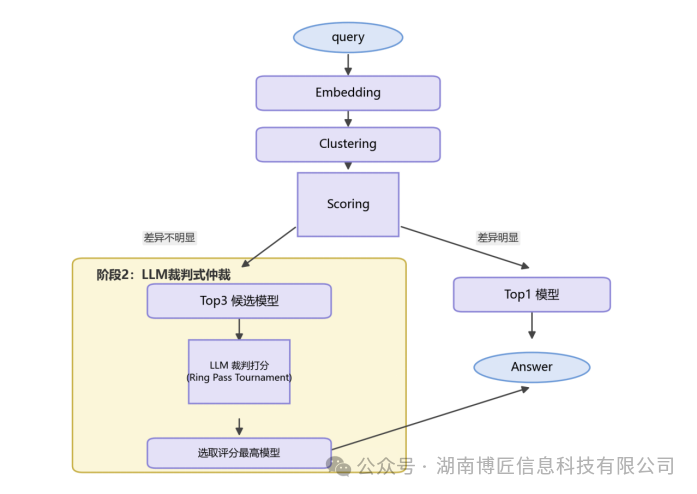
本方案由创新的路由机制与 6 个精选模型组成的模型池构成(整体参数量低于 200B)。系统架构严格遵循“先粗筛、后精判”的漏斗式设计原则:
第一阶段 · 检索式路由(粗筛):基于 Embedding 技术将 Query 映射为连续的语义向量,利用 Clustering 算法划分语义簇,并通过 Scoring 模块融合各模型在所属簇内的历史表现与计算成本。在线推理时,请求被就近分配至对应的语义簇。若判断置信度较高,直接由 Top1 模型响应输出;若置信度不足,则召回 Top3 模型进入下一阶段。该架构下,新模型入池仅需完成离线校准,无需重训整个路由网络,大幅提升了系统的可维护性。第二阶段 · LLM 裁判式仲裁:当 Top3 候选模型的打分差异不显著时,系统调用 LLM 裁判对候选输出进行质量评估。为克服传统全量两两比较带来的 O(n²) 算力开销,系统引入了 Ring Pass Tournament(环形淘汰赛) 机制。通过环形相邻比较、Pivot 交叉补分与最终结果聚合,将仲裁开销骤降至近似 O(n),从而高效精准地选出最优解答。
关键结果一:Top3 召回策略已覆盖大部分高质量答案
数据集 : Router@1 Router@3 模型池 Oracle
HumanEval+: 88.00% 96.00% 96.00%
MBPP+ : 78.07% 87.72% 89.47%
LiveCodeBench v6 : 79.18% 86.12% 87.70%
SWE-bench Verified : 69.33% 80.67% 82.67%
平均 : 78.65% 87.63% 88.96%
实验表明,Top1 路由的平均准确率达到 78.65%,已逼近模型池内的最优单体模型(仅相差 1.16 pp)。当召回策略扩展至 Top3 后,平均覆盖率跃升至 87.63%,全面超越模型池最优单模型(高出 7.83 pp),与理论上限 Oracle(88.96%)的差距收窄至 1.33 pp。这从数据层面证实:高质量答案极大概率已落入候选集中,系统的核心诉求已成功转化为“如何以极低成本完成精准挑选”。
关键结果二:最终平均效果追平并略超 TB 级万亿参数单一大模型
数据集 TB级万亿参数大模型 裁判式仲裁 Oracle 仲裁 vs 大模型
HumanEval+: 91.5% 92.7% 95.7% +1.2 pp
MBPP+: 81.7% 81.8% 86.8% +0.1 pp
LiveCodeBench; 84.5% 83.7% 86.2% -0.8 pp
SWE-bench Verified: 75.0% 75.5% 80.4% +0.5 pp
平均; 83.2% 83.4% 87.3% +0.3 pp
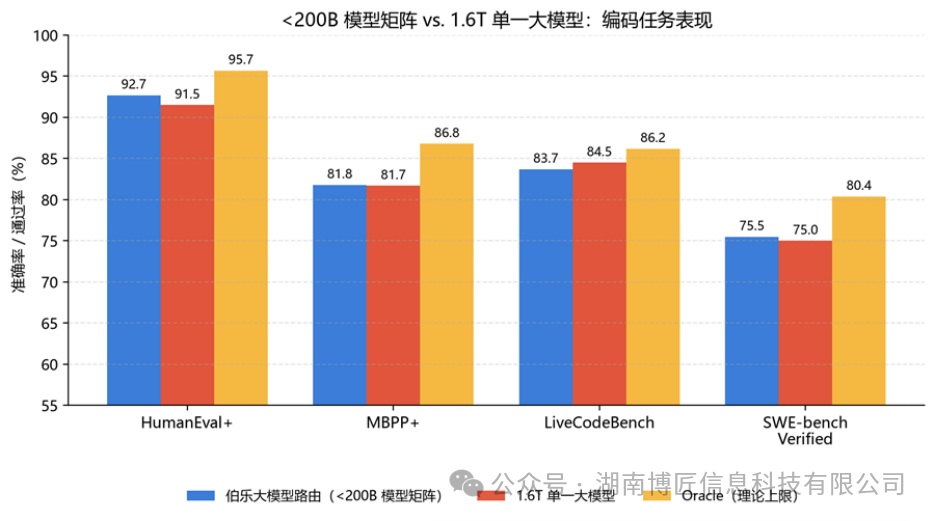
在四个基准测试的综合表现上,仲裁机制以 83.4% 的平均得分超越了 TB 级万亿参数大模型(83.2%),与理论上限 Oracle(87.3%)的差距仅为 3.9 个百分点。具体而言,该机制不仅在全部 4 个基准中均打破了模型池内最优单模型的性能天花板,更在其中 3 个基准上成功击败了 TB 级万亿参数大模型。仅在 LiveCodeBench 测试中以 0.8 个百分点的微弱差距略低于大模型基线,各单项表现距离 Oracle 上限已全面缩窄至 2.5% 到 5.9% 之间。
三、全球顶级 AI 编程能力边端侧部署成为可能
伯乐大模型多模型路由系统验证了“模型矩阵+智能路由调度”的技术范式,以系统级编排取代单体参数堆砌,打通了高性能 AI Coding 在边端侧(边端节点与终端工作站)的落地路径。
资源门槛大幅降低:将对云端 TB 级万亿参数大模型的硬性依赖,转化为对 200B 级参数模型矩阵的按需调用,适配企业私有化部署与边云协同环境。时延与成本极致优化:两阶段路由实现了算力的动态分配;多数高确定性请求由 Top1 直连极速响应,仅极少部分长尾疑难任务触发“Top3+裁判”的精排链路。数据边界安全可控:核心代码处理链路下沉至受控的本地环境中,大幅降低敏感资产跨域流转的风险,天然契合企业合规治理需求。能力演进敏捷解耦:系统具备极强的扩展性,新模型入池仅需离线校准即可,无需对路由器进行全局重训,企业可低成本替换或局部升级系统能力。
伯乐大模型,通过轻量化的基座模型池设计、智能化的路由调度策略以及精准的任务分发机制,解决了高性能AI Coding中“参数堆砌浪费”、“部署门槛过高”、“端侧协同不畅”的实际问题。在边缘端、在本地工作站、在移动终端等每一个需要智能编码的角落,博匠愿做那个敏捷的赋能者,让顶尖编码能力在有限算力下依然从容释放。
