
基于大模型的自主代码智能体(Agent)迭代很快,无论是命令行终端配置,还是跨文件的代码库缺陷修复,都展现出不错的工具调度能力。但在实际落地与高强度评测中,基于 ReAct 或纯提示词框架的智能体普遍卡在同一个瓶颈上—失忆性重复踩坑。我们把这归结为三个问题:① 缺乏跨会话经验沉淀,缺的是把上一轮经验留到下一轮;② 上下文污染与高昂成本,把历史对话直接拼进Context 既消耗 Token,又引入负迁移噪音与幻觉经验;③ 评测作弊与真实泛化的矛盾,记住测试集答案能让榜单好看,换到真实工程任务就失效。
为此,Bole-Agent依托开源的DeepSeek-Harness(DSH)底层框架,适配ACP(Agent Client Protocol),构建了纯宿主端的E/W/rho/C记忆体系与RSI(Recursive Self-Improvement)自进化协议,让智能体在安全隔离的前提下具备复盘反思—独立验证—经验提炼—跨任务复用的能力。
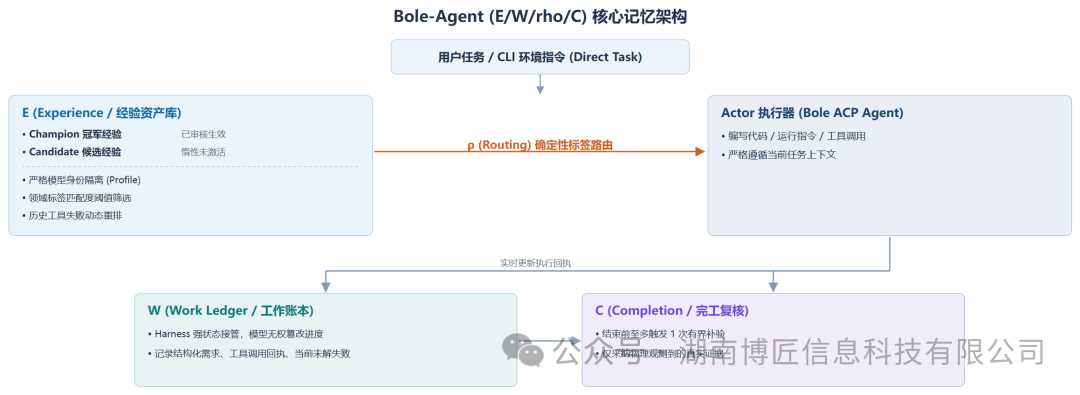
Bole-Agent的自进化能力源于两个支柱:底层的系统解耦记忆架构与上层的自省进化流水线。记忆层拒绝让模型自行篡改记忆或凭空伪造状态,而是通过 Harness 严格托管,抽象出四维状态机。
E(Experience / 经验资产库):经筛选的可复用策略,以模型专属作用域的 Skill 形式提供,分两档——已过验证可生效的Champion,刚总结尚未激活的Candidate。经验按模型完整运行时身份计算SHA-256档案键,杜绝跨模型串扰。
W(Work Ledger / 工作账本):由Harness根据持久Session事件维护的实时状态机,包含当前任务需求、工具调用回执计数与未解决失败项。模型不能自行写进度,也不能伪造证据。
rho(Routing / 路由分发):确定性、有上限地选择与当前任务相关的经验。带标签的经验项须先命中当前任务的领域标签;最近一次工具失败只影响排序,不能让无关经验获得候选资格。
C(Completion / 完工复核):可执行任务结束前至多追加一次有界证据检查,并且只承认物理观测到的真实执行回执,次数设上限以避免收尾阶段空转。
基于上述记忆底座,Bole-Agent 实现了标准化的 RSI 控制层,整条流水线拆成四步:
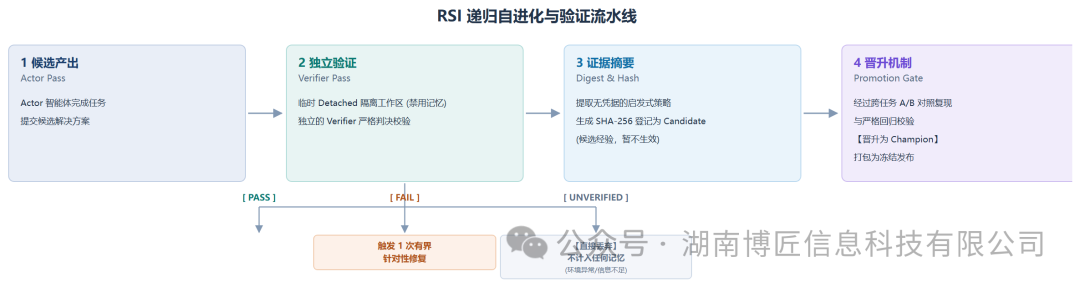
① 候选产出(Actor Pass),执行侧完成任务,提交候选方案;
② 独立验证(Verifier Pass),方案投递至临时 Detached 隔离工作区,在禁用记忆下由独立 Verifier 跑出唯一确定性断言(RSI_VERDICT: PASS/FAIL);
③ 证据摘要(Digest & Hash),通过的方案剥离所有凭据,生成 SHA-256 摘要后登记为 Candidate(暂不生效);
④ 晋升机制(Promotion Gate),候选经验经跨任务 A/B 对照复现与回归校验,确认稳定正向收益才晋升为Champion,打包为冻结发布。
围绕这四步,我们设置了三道工程防线。
防线一:严格隔离的评估栅栏(Evaluator Fence)—绝不走捷径。官方评测基准的隐藏测试套件完全屏蔽在自进化回路之外,智能体只能依据公开业务定义与环境执行回执总结经验;任何环境偶发超时或异常直接标为UNVERIFIED,严防脏数据污染。
防线二:Actor与Verifier 双角色解耦验证—自省不能陷入自说自话。方案由独立角色在干净沙箱跑出唯一确定性断言;判为 FAIL 时仅允许至多 1 次有界修复与复验,杜绝资源死循环。
防线三:从Candidate到Champion的晋升淘汰制,新经验必须携带 SHA-256 证据摘要,过滤密码、私钥、凭据赋值与题目专有数据,先作为未激活的 Candidate 存储;只有通过 A/B 对照复现、证明稳定正向收益后,才能晋升为 Champion 并绑定专属模型档案。
在操作系统底层的极端任务下,智能体自己总结并晋升了多条高价值工程规律。其中一条与后台服务的生命周期有关。
踩坑现场:部署gRPC微服务、Nginx、本地推理服务或QEMU虚拟机时,智能体习惯直接用后台作业编号启动进程。会话退出时,作业清理机制会把关联的后台进程一并终止,外部评测器随后探测端口,拿到的是连接拒绝。在kv-store-grpc、pypi-server、qemu-alpine-ssh这类任务上,同一个错误反复出现。
RSI 进化沉淀:
智能体复盘后生成了如下规范策略并固化到记忆中——对于需在智能体退出后长期存活的服务,不得依赖普通的后台作业编号;必须通过系统服务管理器启动,或在独立会话中通过setsid nohup<command></dev/null >/tmp/<log>2>&1 & 启动,彻底切断所有标准流;启动后用全新独立命令探测端口监听状态,确认进程Session ID 与启动Shell解耦,最后以真实客户端请求检验服务健康度。
在严格对照的评测环境下,Bole-Agent搭载伯乐大模型专家模型2与伯乐大模型专家模型1两款主力开源底座,在业内公认难度最高的两大基准上做了全量实测,自进化回路全程不接触隐藏测试集。
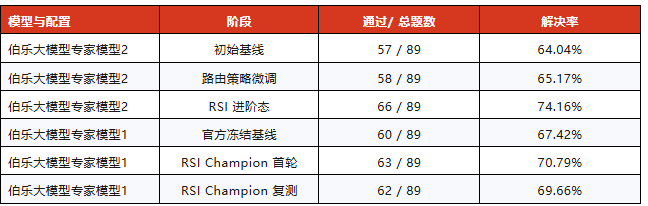
Terminal-Bench 2.1(89 道 OS/CLI 真实系统工程任务):涵盖系统内核、逆向分析、复杂网络与并发等严苛操作。伯乐大模型专家模型2底座上,初始基线57/89(64.04%),经输出格式约束与长耗时分支处理后58/89(65.17%),接入 RSI 进阶态后达到66/89(74.16%),净增 9 题;伯乐大模型专家模型1底座上,官方冻结基线60/89(67.42%),接入RSI Champion首轮63/89(70.79%),新增攻克pypi-server、qemu-ssh等11项复杂服务任务,独立复跑第二轮62/89(69.66%)。两轮相差1题,说明提升可复现,不是单次波动。
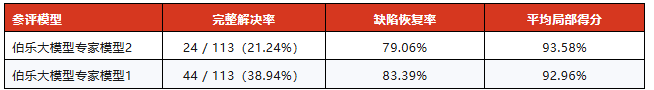
DeepSWE(113道真实大型开源代码库缺陷修复):面向大规模工业级代码库,考察智能体定位复杂调用栈、修复缺陷并保持既有测试不被破坏的能力。伯乐大模型专家模型2完整解决24/113(21.24%),缺陷恢复率79.06%,平均局部得分 93.58%,原有测试保持率 99.05%;伯乐大模型专家模型1完整解决44/113(38.94%),缺陷恢复率 83.39%,平均局部得分 92.96%。未完全通过的子集中超过83%的失效测试被成功恢复,说明每次反思后形成的修改习惯是可控的。
这套体系只是第一阶段。下一步,我们把成熟的E/W/rho/C宿主记忆底座、隔离评测防护与RSI经验提炼机制,原生打通并沉淀至公司自研的伯乐大模型基座,在基础预训练与后训练之上,把经多轮验证的先验知识内化为模型的固有能力,让下游调优不再依赖海量人工打标,也不再靠扩大上下文来补经验。
RSI的底层逻辑是——通过确定性的物理/工具环境反馈驱动自省,把隐性知识萃取为显性资产。这一范式不只适用于代码与终端运维,同样可突破专业工业壁垒:面向计算机视觉,把目标检测、工业缺陷识别、遥感与质检等处理链路的调用反馈,抽象为可复用的视觉诊断规则;面向复杂电磁仿真与信号计算,调度专业求解器完成电磁场求解、网格剖分与天线参数优化,自主总结高阶工程经验。
大模型的参数量与预训练决定了智能的下限,而系统架构、记忆工程与自我进化能力,决定了智能体在真实工业世界落地的上限。Bole-Agent证明:只要给智能体一套科学的反思规则与可审计的经验闭环,模型就能在与环境的真实交互中不断进化、持续复利。目前这套体系正加速向生产环境适配,后续将与伯乐大模型基座打通。
